2016年5月14日土曜日

自治体におけるRESASの活用事例集

 三度の飯よりRESAS(リーサス:地域経済分析システム)が好きな僕です。
いつの間にか、 ひっそりとRESASの画面に「自治体による(RESASの)利活用事例集」が掲載されていたので軽くご紹介です。

>毎回しつこいですが、「RESAS 見れない」で検索されている方へ 
 RESASはグーグルのChrome(クローム)ブラウザでしか使えません。FirefoxやIE、クロームの互換ブラウザ(Chromium)でも動作しませんのでご注意ください。


利活用事例集の置き場所や内容など 


 ちょっとわかりづらいのですが、画面右上の「・・・」をクリックしてください。

https://resas.go.jp/case/#/13/13101

 URL変わらず、「利活用事例集」フレームのみ切り替わります。


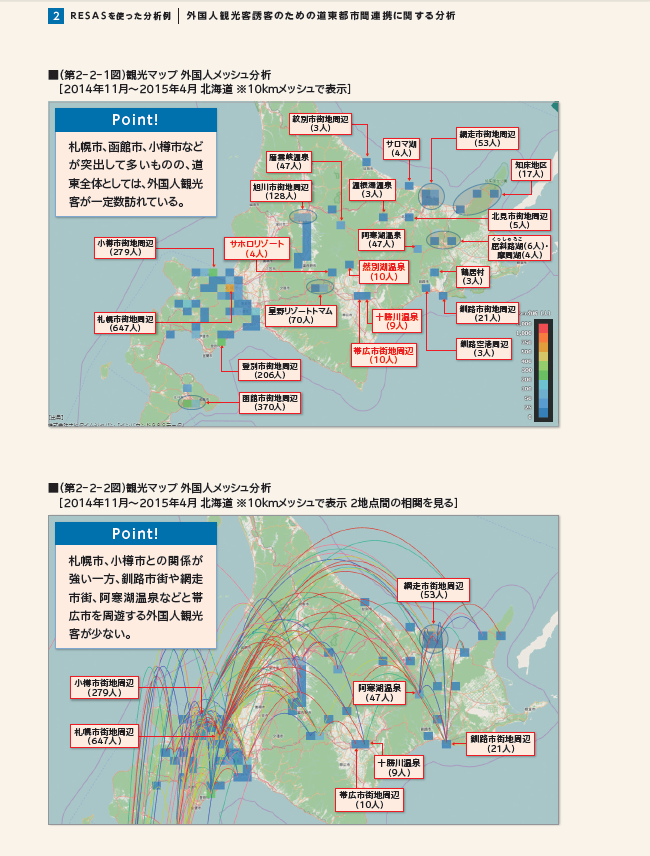
  各自治体で「RESASをうまく使った事例(僕の意訳w)」が綺麗にまとまっており、道内事例として「札幌市」と「帯広市」が紹介されています。

 札幌市は近年外国人観光客が爆発的に増えていることもあり、今回のお題目も彼らの動向分析も盛り込まれてます。


 札幌市と周辺観光地の外国人観光客の動きを見たり、


 札幌市内における主要観光スポットでの外国人観光客数の大小をメッシュ分析で検証していたりします。


  こちらは、「帯広市」。同じ仕組みを使っていても着眼点が異なる分析をされていて面白いです。


  特に、周辺自治体との比較し、滞在人口ピークが帯広市はやや遅い時期にあるといった発見は結構面白いですよね。


また、 道内主要観光地における外国人観光客数のボリュームを見つつ、道東圏の観光地間での周遊促進が課題であることも可視化されています。


 この他、道外事例もたくさん紹介されていますので、ご興味ありましたら是非ご覧ください。

その他RESAS関連エントリー 


ニセコ町の基礎データをリーサスでサクッと作ってみた(1時間限定で)
(http://sapporomkt.blogspot.jp/2015/06/1.html)

超簡単&無料!大空町「芝桜公園」の人の動きをアニメーションGIF化っ!
(http://sapporomkt.blogspot.jp/2015/05/gif.html)

クライアント向け「RESAS(リーサス)勉強会」やってみて感じたこと。
(http://sapporomkt.blogspot.jp/2015/05/resas.html)

北見市人口データを地域経済分析システム(リーサス)で覗いてみた。
(http://sapporomkt.blogspot.jp/2015/05/blog-post_3.html)

札幌市の自治体パワーを「地域経済分析システム」で検証 経済活動等編
(http://sapporomkt.blogspot.jp/2015/04/blog-post_96.html)

札幌市の自治体パワーを「地域経済分析システム」で検証 経済構造編
(http://sapporomkt.blogspot.jp/2015/04/blog-post_26.html)

札幌市の観光データを「地域経済分析システム(RESAS(リーサス))」で見ると・・・
(http://sapporomkt.blogspot.jp/2015/04/resas_25.html)

札幌市の人口データを「地域経済分析システム(RESAS(リーサス))」でゴニョゴニョしてみた。
(http://sapporomkt.blogspot.jp/2015/04/resas_23.html)

(速報!!)「地域経済分析システム(RESAS(リーサス))」がリリース!
(http://sapporomkt.blogspot.jp/2015/04/resas.html)

2016年5月13日金曜日

SPSS Modelerで「サイアー/ブルードメアサイアー」データをレコード結合


 前回は、日本におけるサラブレッドのサイアーランキングデータを使ってレコード追加等をお勉強しました。

SPSS Modelerでリーディングサイアーデータ分析:前処理(レコード追加等)
http://sapporomkt.blogspot.jp/2016/05/spss-modeler.html

 競馬ファンとしては、日本のサラブレッド競争馬の父であるリーディングサイアーを見たからには、「母の父」にあたる「ブルーメアサイアー」との関係性も見たくなるもんです。 毎度のことですが、異論は認めません(笑)

 例えばこんなイメージで

※本エントリーは、私、小田一弥が一個人として勉強を兼ねて記載したものです。
   私の勤務先である日本アイ・ビー・エム株式会社の見解・見識ではない、個人としての記載内容としてご覧ください。 


もう少し、「ブルードメアサイアー」のウンチクを。


Wiki曰く、下記でございます。

「ブルードメア」は「繁殖牝馬」を意味し、「サイアー」は「(特定の馬に対する)種牡馬」「父馬」を意味する。母の父。頭文字をとってBMSと略されることも多い。

競走馬生産者の間では、父馬、母馬、ブルードメアサイアーが競走馬の能力に強く影響を及ぼすと言われ、ブルードメアサイアーとしての勝利回数、入着賞金額を集計したランキングも存在する。

そんなに難しくなかった「レコード結合」の手順


 私、SPSS Modelerは初心者なので「レコード結合」ノードは始めて触ったのですが、思っていたよりも簡単でした。


1.「Excel」ノードでブルードメアサイアーデータを読み込み
 前回エントリー同様、日本における2007~2016年におけるブルードメアサイアーデータを準備し、「Excel」ノードで入力しました。ちなみに、今回は各年度で全データを集めるのは大変だったので、上位300頭だけにしたため、若干数値がずれると思いますがご了承ください。

 すべて入力後、 「レコード設定」パレットの「レコード追加」ノードでデータをつなげてください。
「リーディングサイアー」同様、ストリームが見づらくなるので、「スーパーノード」で格納すると便利だと思います。


2.「テーブル」ノードで確認
 このあたり、もう慣れましたよね。一応、読み込ませた内容をチェックしてください。
ここでは「種牡馬名」をキーにして「リーディングサイアー」データと結合させるのが狙いです。


3.「レコード集計」ノードで各指標を集計
 こちらも前回エントリーと全く同じ手順です。


4.「レコード結合」ノードで「リーディング/ブルードメアサイアー」を結合
 「レコード設定」パレットから「レコード結合」ノードを選択し、下記のように結合させてください。
(「フィルター」ノードは途中でフィールド名を変えただけなので無視してください)


「レコード結合」ノードを開くと、下記のようにどのノードから接続されたかわかるようになっているので、注釈で命名しておくといいですね。


 「レコード結合」タブで「種牡馬名」を結合キーに指定します。


5.「フィールド順序」ノードでフィールドを並び替え
 いつもどおり、ご自分で見たいフィールドの順番に並び替えてください。


6.「ソート」ノードで降順/昇順を指定
 こちらも同様に、各フィールドにおけるレコードの表示順を指定してください。


7.「サンプリング」ノードでレコードを抽出
 今回、初めてご紹介するのが「サンプリング」ノード。「レコード設定」パレットにあります。
下記のように設定すると先ほどのソート順に上位20レコードを抽出してくれます。


8.「散布図」ノードを配置
 あとは「散布図」ノードを使って、下記のように設定します。

X軸:リーディングサイアーの収得賞金全額(07~16年)
Y軸:ブルードメアサイアーの収得賞金全額(07~16年)
散布図におけるプロット名:種牡馬名


 下記は冒頭に掲載した散布図です。実はやる前からわかっていたのですが、今回のやり方だけでは両者の関係性をしっかり見ることは出来ません。それは、「ブルードメアサイアー」は「母の父」なので、「父」よりも1世代ずれてしまうからです(種付け+出産+デビュー期間までの育成期間)

 もし精緻に関連性を見るのであれば、「初年度デビュー産駒に限定する」といったデータの取り方が必要になると思いますが、今回の目的は「種牡馬名をキーにしてレコードをつなげる」ことなのでご容赦ください。

 とはいえ、散布図を俯瞰すると、ブルードメアで「サンデーサイレンス」が突出していることがわかりますね。「ディープインパクト」の父としても有名な大種牡馬ですが、死没したのは2002年なので、リーディングサイアーでもそこそこのポジションにいることは、実は凄いことですね。


 こちらは各年度における「AEI」の合計値をX軸:リーディングサイアー、Y軸:ブルードメアサイアーでプロットしたものです。「AEI」は1頭における獲得賞金の大きさを示す指標なのですが、Y軸を見ると「メジロマックイーン」が突出して高いことがわかります。

 当馬は日本のクラシックレース三冠を達成した「オルフェーヴル」やクラシック二冠や有馬記念を制した「ゴールドシップ」の母の父としても有名ですね。「サンデーサイレンス」のようにケース(頭数)が多くなくても、前述した大物を算出すると下記のような結果になりやすいということですね。


 今回は、完全に趣味の世界に走ってしまったので、次回はもう少し分析チックなことをやってみる・・・かもしれません(笑)

その他:SPSS Moder関連エントリー


SPSS Modelerでアソシエーション分析がしたいっ! (前処理編〜縦持ちを横持ちへ)
http://sapporomkt.blogspot.jp/2017/06/spss-modeler.html


「SPSS Modeler」におけるデータ操作及びシーケンスデータの取り扱いまとめ
http://sapporomkt.blogspot.jp/1970/01/spss-modeler_1.html

SPSS Modelerでリーディングサイアーデータ分析:前処理(レコード追加等)
http://sapporomkt.blogspot.jp/2016/05/spss-modeler.html
2016年5月8日日曜日

日韓で異なる動物の鳴き声表記Ver0.1

 すいません。こんなエントリーのために貴重なパケットを使って頂いて。
だって、明日から連休明けちゃいじゃないですか。
だからこそ、韓国人の嫁さんとそのお母さんの合計2サンプルに聴取してですね、
日韓で異なる動物の鳴き声表記リストを書いてみたとですよ。
 なお、信憑性は結構自信ないので、ご指摘いただき次第、随時更新しようかと。

日韓 動物の鳴き声表記Ver0.1


動物 日本語 韓国語
犬 ワン モン
猫 ニャー ヤォン
馬 ヒヒーン ヒヒーン
ヤギ メェー メェー
牛 モォー ウンメェー
豚 ブーブー クゥルクゥル
カラス カーカー カーカー
スズメ チュンチュン チェクチェク
ハト クルックー ググググ
ゾウ パォーン (無いんですって!ビックリ!)
オットセイ オッオッ アォアォ
サル キキキキ キャッキャッ

「牛」が怪しい・・・これ、ヒツジじゃないの?
 ゾウは、日本式を言われたら、「あー、そうだ。パォーン」だわというノリ。
 そもそも、僕の日本語表記がズレてないか心配です(笑)


ゼロからしっかり学べる!韓国語 文法トレーニング
木内 明
高橋書店
売り上げランキング: 10,771

わずか3分!GA+Adsense連携でお金になる記事を一発で把握する方法

 ちょっと釣りっぽいタイトルですが、本当にそのままの内容なのでご容赦ください。
2015年2月から当ブログをはじめたのですが、Adsenseは自分で分析等に使えるアクチュアルデータが欲しかったので何も考えずに設定していました。

 とはいえ、微々たるものですが、毎月1冊ぐらいは本を買える収入になりつつあるので、これまでの振り返りを踏まえて「どの記事がクリックされたか」を調べるためにGoogle Analytics + Adsenseの連携方法を調べてみました。

ホントに3分で出来ちゃう、GA+Adsense連携手順


1.Google Analyticsにログイン
 まずは、下記からGAにログインしてください。


2.「アナリティクス設定」を選択
 画面上部の場所から「アナリティクス設定」を選択してください。


3.「Adsenseのリンク設定」を選択
 初見でもどこを選ぶべきかすぐわかるぐらい簡単です。「Adsenseのリンク設定」を選択してください。


4.「新しいADSENSEクリック」を選択
 ・・・で、ここで驚愕の事実が発覚ですよ、奥さん。
てっきりやっていないと思っていた「GA + Adsense連携」、完了済みでした(笑)
あ、あれっ?いつやったんだろう? 本当に覚えていないのですが、すいません。。


5.「完了」ボタンをクリック
 Adsense連携登録が終わると、下記のような画面になるはずです。「完了」を押して終わりです。
当ボタンをクリックしてから連携データの取得が可能になるため、その点だけご留意ください。


6.GAで「ランディングページ」から「Adsense」を選択
 Google Analyticsで「行動>サイトコンテンツ>ランディングページ」を選択すると、下記のようなタブが画面上部に見えるので「AdSense」を選ぶとクリックされた記事の一覧が表示されます。


 可能であれば具体的な数値も見てもらいたいのですが、数値公表はGoogleの規約で禁止されているのですいません。ただ、あまりクリックに結びついていないと思っていた民泊関連で有名な「Airbnb(エアービーアンドビー)」のクリック率が高かったのは驚きでした。

 その他、鶴雅グループの「森の謌(もりのうた)」や函館にオープン予定の「大沼鶴雅オーベルジュ エプイ」公式ページ」もクリック率が良かったですね。逆に、インプレッション数が多い割りにクリック率が低調だったのが、「日本版DMO」も意外でしたね。

 せっかくなので、これからは各記事のクリック率も気にしながらエントリーを書いてみようかと思います。


箱崎町来たら、「鯛ふじ」の鯛丼はマストで。

 オフィスが日本橋箱崎町にあるのですが、若干、都心のビジネス街と比べるとランチ場所が少なくて困ることがあります。かと言って、新宿あたりの高層ビル群もちょっと苦手なので、まぁ、無いものネダリなんですが・・・。

 そんな箱崎町ですが、実は幾つか有名なお店があったりします。
その中でも鯛料理の「鯛ふじ」さんはかなりオススメです。

 お店構えはこんな感じ。若干、目立たないところにあるので、初めての方は事前にしっかり地図を調べておいた方がいいかもしれません。


 お品書き。若干、お値がはる感じもしますが、お値段以上の価値はありますよ。
この中で一番のお勧めは「鯛丼(大盛り):1,500円」。


 2階にも席があるようですが、自分はいずれの訪問もカウンター席で頂きました。
結構な人気店なので、お昼ジャストだと座れないかもしれません。11:30頃だと大丈夫かと思います。

 肝心の味ですが、評判どおり、かなり美味しいです。この味とボリュームで1,500円なら文句なしですね。


お店情報など


・店名    :鯛ふじ
・電話    :03-3666-7724
・住所    :東京都中央区日本橋箱崎町14の7
・営業時間    :11:30~13:30(ランチ営業)、17:30~22:00
・定休日    :土曜日・日曜日・祝日

2016年5月7日土曜日

これでたったの200円!?「新宿御苑大温室」が思いのほか良かった件

 ここ数日、データモデリングのエントリーばかりで若干乾いたブログになってきたので、心潤う場所をご紹介します(笑)

 先日、家族で散歩がてら「新宿御苑」に行ってきたのですが、思いのほか良くって、これから定期散歩コースにしちゃうおうかと思っています。

改めて、「新宿御苑」とは?


 1906年開園の国民公園で、環境省所轄の庭園です。明治39年に皇室の庭園として造成されましたが、その中でもガラス張りの建物「新宿御苑大温室」は1958年に完成し、当時としては東洋随一の規模だったそうです。2007年に一旦閉館し、2012年にリニューアルオープンしました。
毎年、花見シーズンには入園切符を買うのにも時間がかかるほど、多くの来場客が集まります。

新宿御苑 | 一般財団法人国民公園協会
http://fng.or.jp/shinjuku/

「新宿御苑大温室」って無料でいいの?


 もちろん、無料のままで続けて欲しいのですが(笑)、これが本当に無料なの?と思うぐらい、「新宿御苑大温室」は凄い楽しめます(新宿御苑の入園料として200円はかかりますが)。

 温室内に各国の貴重な植物を集めた自然庭園が展開されているのですが、ここからは、小難しい説明無しで写真だけご紹介です。


  バナナやマンゴーといったフルーツも結構あります。もちろん、食べられませんが(笑)


 温室内は思ったよりも大きく、早歩きで流しで見ても15分近くはかかります。


 温室内には滝や川もあり、ちょっとしたアマゾンのような空間になっていますので、小さなお子さんと一緒でも探検気分で楽しめると思いますよ^^


 ちなみに、外の水たまりにはオタマジャクシやアメンボ等、沢山の生き物がいました。

施設情報など


・開園時間    9:00~16:00 (16:30閉園)
・温室        9:30~15:30(16:00閉館)
・散策路        9:00~16:30
・休園日    毎週月曜日(月曜日が休日の場合は翌平日)
        年末年始(12月29日~1月3日)
・入園料    一般(15歳以上)200円 小・中学生50円 幼児無料
※30人以上団体割引あり(大人(15歳以上)150円 小・中学生25円)

2016年5月4日水曜日

SPSS Modelerでリーディングサイアーデータ分析:前処理(レコード追加等)

 前回までの合計8回にわたり、「SPSS Modeler」によるデータ操作やシーケンスデータの処理ついて学んできました。余談ですが、そろそろオッカナイ先輩に「Modelerマスターしたよね?」って聞かれそうでブルブルしております(笑)

「SPSS Modeler」におけるデータ操作及びシーケンスデータの取り扱いまとめ
http://sapporomkt.blogspot.jp/1970/01/spss-modeler_1.html

 これからは、複数ファイルのデータ結合などについて学んでいきますが、今回は日本競馬における「リーディングサイアー」データを使って、同一フィールド構造を持っているデータの結合を行ってみます。

※本エントリーは、私、小田一弥が一個人として勉強を兼ねて記載したものです。私の勤務先である日本アイ・ビー・エム株式会社の見解・見識ではない、個人としての記載内容としてご覧ください。  

そもそも、「リーディングサイアー」ってなに?


Wiki曰く、下記でございます。 

リーディングサイアー (Leading Sire) とは、ある国、ある地域、もしくは団体において、1シーズンの産駒の獲得賞金の合計額による種牡馬の順位のこと、または単にその順位で1位になった種牡馬のことである。(Wikipediaより)

 今回は、2007~2016年におけるサラブレッドのサイアーランキングデータを個別に取得し、「SPSS Modeler」でひとつのファイルにつなげるところまでトライします。 

思ってたよりも簡単な前処理


フィールド構造が全く同じなので、思っていたよりも簡単でした。

 1.「Excel」ノードを配置し、各年度のファイルを読み込み
 「入力」パレットにある「Excel」ノードを配置し、10年分のサイアーデータを配置してください。
データ選択ミスを低減するためにも、「注釈」で名前を付けておいた方がいいかもしれませんね。


2.「レコード追加」ノードを配置し、各年度の入力ファイルをつなげる
  「レコード設定」パレットから「レコード追加」ノードを配置し、各年度の入力ファイルからストリームをつなげてください。


 個別につなげると面倒なので、下記のようにドラッグ&ドロップで一括選択した上でつなげるとラクです。


 「レコード追加」ノードを開くと、下記のように表示されました。


3.「データ検査」ノードを配置し、データ内容をチェック
全部で7,000レコード近くあるデータなので、念のため、「データ検査」ノードでデータ内容をチェックします。


 す、す、すいません・・・。フィールド名間違っていたので、「フィルター」ノードを使って修正しておきます(テヘッ)


4.「レコード集計」ノードを配置し、気になるフィールドを集計
「レコード設定」パレットから「レコード集計」ノードを配置し、幾つかのフィールドを選択します。
今回は各種牡馬の大まかなランキングだけ見れればよいので、下記のように設定しました。


5.「フィールド順序」ノードを配置
 「フィールド設定」パレットから「フィールド順序」ノードを配置し、注視したいフィールド順に並び替えます。


 ソートの順番は「収得賞金全般(万円)_Sum」で降順してから、種牡馬名で昇順にしました。


6.「テーブル」ノードで確認
 一位は、「キンカメ」こと「キングカメハメハ」。2004年に「NHKマイルカップ」と「東京優駿(ダービー)」の変則二冠を達成した名馬です。ここ数年クラシックレースを総ナメしている「ディープインパクト」は意外にも2位ですが、「キンカメ」より種牡馬デビューが先のためです。


 次回以降は、もう少し細かく当データを眺めていきたいと思います。

その他:SPSS Moder関連エントリー


「SPSS Modeler」におけるデータ操作及びシーケンスデータの取り扱いまとめ
http://sapporomkt.blogspot.jp/1970/01/spss-modeler_1.html